W tym artykule
W skrócie
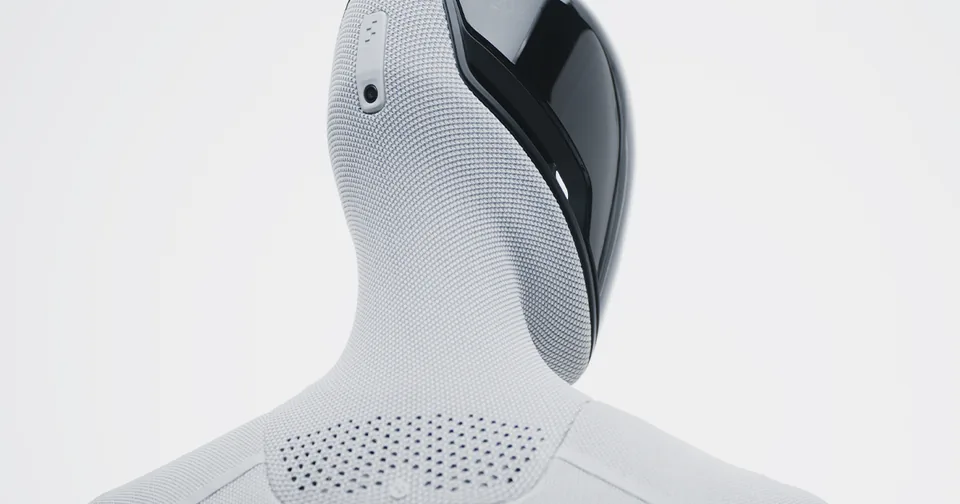
- Omawiane modeleFigure 03
- Omawiane modele dostępne w Polsce0 z 1
- Liczba źródeł5
- Czas czytania5 min
- Stan2 października 2026
Od zdalnego sterowania do modeli, które „rozumieją” polecenie
Jeszcze do niedawna robot humanoidalny wykonujący konkretne zadanie musiał mieć to zadanie zaprogramowane ręcznie albo pokazane przez operatora w trybie teleoperacji. Przełom ostatnich lat to modele wizyjno-językowo-akcyjne (Vision-Language-Action, VLA) — systemy AI, które przyjmują obraz z kamer robota i polecenie w języku naturalnym („podnieś czerwony kubek i postaw go na półce”), a zwracają bezpośrednio sekwencję ruchów. To one odpowiadają za to, że model taki jak Figure 03 może chwycić przedmiot, którego nigdy wcześniej nie widział, bez osobnego programowania tego konkretnego chwytu. Jak to się ma do reszty architektury robota — sensorów, aktuatorów i komputera pokładowego — opisujemy w „Jak działa robot humanoidalny”.
Jak działa typowy model VLA
Większość dzisiejszych modeli VLA opiera się na dwuwarstwowej architekturze, która rozwiązuje podstawowy konflikt: modele rozumiejące język i obraz są duże i wolne, a sterowanie ruchem musi być szybkie.
Dobrze widać to na przykładzie modelu Figure Helix, stworzonego przez Figure AI i opisanego w lutym 2025 roku: „System 2” to 7-miliardowy model wizyjno-językowy działający z częstotliwością 7–9 Hz, który analizuje scenę i polecenie i przekłada je na wewnętrzny wektor semantyczny. „System 1” to znacznie mniejszy, 80-milionowy model transformerowy działający przy 200 Hz, który na podstawie tego wektora generuje w czasie rzeczywistym ciągłe sygnały sterujące dla całej górnej połowy ciała — 35 stopni swobody, łącznie z pojedynczymi palcami, nadgarstkiem, tułowiem i głową. Oba systemy są trenowane od początku do końca wspólnie, a Figure deklaruje, że model nauczył się tego zachowania na około 500 godzinach demonstracji z teleoperacji; firma nie podaje niezależnie zweryfikowanego wskaźnika sukcesu zadań poza własnymi materiałami.
Najważniejsi gracze na rynku modeli VLA w 2026 roku
NVIDIA Isaac GR00T. Według NVIDIA otwarta platforma referencyjna dla robotów humanoidalnych, łącząca otwarte dane, potoki przetwarzania danych i wytrenowany model fundamentalny przyjmujący obraz i język, a zwracający akcje. Trenowany na danych rzeczywistych, syntetycznych oraz materiałach wideo w skali internetu, zbudowany wokół symulatorów NVIDIA Omniverse i Cosmos oraz biblioteki CUDA-X, z docelowym sprzętem Jetson Thor do wnioskowania w czasie rzeczywistym. GR00T potrafi wykonywać zadania manipulacyjne — chwytanie, przenoszenie przedmiotów jedną lub dwiema rękami, przekazywanie przedmiotu między rękami — oraz zadania wieloetapowe w takich zastosowaniach jak transport materiałów, pakowanie i inspekcja. NVIDIA opisuje GR00T jako otwartą platformę; zakres dostępności kodu i wag poszczególnych wersji trzeba sprawdzić w repozytorium NVIDIA.
Google DeepMind Gemini Robotics. Według DeepMind rodzina obejmuje trzy warianty: Gemini Robotics 2 (pełny model VLA z kontrolą całego ciała humanoida i zręcznością na poziomie np. zawiązywania węzła), Gemini Robotics-ER 2 (wyspecjalizowany w rozumowaniu przestrzennym i wieloetapowym planowaniu) oraz Gemini Robotics On-Device 2 (lekka wersja do lokalnego uruchamiania bezpośrednio na sprzęcie robota, bez połączenia z chmurą). DeepMind rekrutuje ponad 100 zaufanych testerów przez listę oczekujących, a wśród partnerów badawczych wymienia Agile Robots, Apptronik i Boston Dynamics — model nie jest więc jeszcze otwarcie dostępny dla dowolnego integratora.
Physical Intelligence — pi0 / pi0.5. Firma Physical Intelligence rozwija rodzinę generalistycznych modeli VLA pi0 i pi0.5. Architekturę, zakres udostępnionego kodu i wyniki testów opisują oryginalne publikacje firmy; przed zacytowaniem liczb warto sięgnąć do nich bezpośrednio.
Modele otwarte i akademickie. OpenVLA to 7-miliardowy otwarty model wytrenowany na 970 tys. epizodów robotycznych ze zbioru Open X-Embodiment, łączący enkodery wizyjne SigLIP i DinoV2 z modelem językowym Llama 2 7B. Według autorów przewyższa w większości testów sterowania wieloma robotami zamknięty model RT-2-X (55 mld parametrów), ale RT-2-X wypada lepiej w trudnych zadaniach uogólnienia semantycznego, które wymagają wiedzy z internetu. Projekt AgiBot World udostępnia zbiór danych (wersja Beta: 1 003 672 trajektorie, ok. 43,8T, jak podaje repozytorium) oraz model GO-1; model otwarto 19 września 2025 roku.
Co te modele już potrafią
- Chwytanie nieznanych wcześniej przedmiotów na podstawie samego polecenia językowego, bez osobnego trenowania na tym konkretnym obiekcie — to jedna z flagowych zdolności demonstrowanych zarówno przez GR00T, jak i Helix.
- Współpracę dwóch robotów przy jednym zadaniu na podstawie poleceń w języku naturalnym — zademonstrowana przez Figure przy użyciu Helix.
- Jeden zestaw wag modelu do wielu zadań, bez konieczności osobnego douczania (fine-tuningu) pod każde nowe zadanie z osobna — to kierunek, w którym zmierza cała branża, odchodząc od wcześniejszego podejścia „jedno zadanie = jeden wytrenowany model”.
- Rozumowanie przestrzenne i planowanie wieloetapowe — tym zajmuje się według DeepMind wariant Gemini Robotics-ER 2.
Czego te modele jeszcze nie potrafią
Żaden z publicznie dostępnych materiałów producentów nie podaje niezależnie zweryfikowanego wskaźnika powodzenia zadań w warunkach produkcyjnych, poza kontrolowanymi demonstracjami — to samo w sobie jest sygnałem, że branża wciąż jest na etapie dowodzenia koncepcji w wybranych zastosowaniach, a nie uniwersalnej gotowości operacyjnej. Do jawnie nierozwiązanych, powszechnie wskazywanych w literaturze problemów należą:
- Generalizacja poza rozkład danych treningowych — model trenowany na typowych przedmiotach domowych czy magazynowych może zawodzić przy nietypowych kształtach, materiałach czy oświetleniu, których nie było w danych.
- Długoterminowe planowanie wieloetapowe — łańcuchy więcej niż kilku kolejnych kroków wciąż są trudniejsze niż pojedyncze akcje chwytania czy przenoszenia.
- Bezpieczna autonomia bez nadzoru — większość obecnych wdrożeń przemysłowych, np. Figure 03 w fabryce BMW w Spartanburgu, działa w nadzorowanym, pilotażowym trybie, a nie w pełnej autonomii operacyjnej.
- Ilość i jakość danych treningowych specyficznych dla danego ciała robota (embodiment) — modele takie jak GR00T czy GO-1 częściowo rozwiązują to poprzez łączenie danych z wielu robotów, ale przenoszenie umiejętności między różnymi konstrukcjami mechanicznymi pozostaje aktywnym obszarem badań, nie rozwiązanym problemem.
Dlaczego to ma znaczenie przy wyborze robota
Model VLA, na którym pracuje dany robot, w praktyce decyduje o tym, jak elastycznie można go wdrożyć do nowych zadań bez kosztownego, indywidualnego programowania. Przy porównywaniu modeli w kategorii „Roboty humanoidalne” warto sprawdzić, czy producent w ogóle deklaruje, na jakim modelu AI pracuje robot (własny, jak Helix, czy oparty na platformie referencyjnej, jak GR00T), i czy podaje to z konkretnym źródłem — a nie tylko marketingowym hasłem „sztuczna inteligencja”. Kontekst rynkowy i prognozy dla całej kategorii humanoidów znajdują się w „Prognozy rynku robotów humanoidalnych”, a liczba stopni swobody, którymi taki model faktycznie steruje, jest wyjaśniona w „Stopnie swobody (DOF) w robotach humanoidalnych”.
Najczęściej zadawane pytania
Co to jest model VLA (Vision-Language-Action)?
To model sztucznej inteligencji, który na wejściu przyjmuje obraz z kamer robota oraz polecenie w języku naturalnym, a na wyjściu generuje sekwencję konkretnych ruchów (trajektorię akcji) — w odróżnieniu od klasycznych modeli językowych, które generują tylko tekst.
Czy model VLA to to samo co ChatGPT zamontowany w robocie?
Nie. Modele językowe (LLM) generują tekst i nie mają bezpośredniego dostępu do sterowania silnikami. Modele VLA są trenowane specjalnie na danych robotycznych — nagraniach ruchu połączonych z obrazem i poleceniem — i ich wyjściem są konkretne parametry ruchu, a nie słowa.
Które modele VLA są dziś najbardziej zaawansowane?
Na rynku komercyjnym wyróżniają się NVIDIA Isaac GR00T (otwarta platforma referencyjna), Figure Helix (zastrzeżony, własny model Figure AI) oraz Google DeepMind Gemini Robotics 2 (dostęp partnerski/lista oczekujących). W środowisku akademickim/open source liczy się OpenVLA i model GO-1 od AgiBot World.
Czego modele VLA jeszcze nie potrafią w 2026 roku?
Największe otwarte problemy to: generalizacja na zupełnie nowe, nieprzewidziane sytuacje poza danymi treningowymi, długoterminowe planowanie wieloetapowych zadań, oraz bezpieczne działanie bez nadzoru człowieka w nieustrukturyzowanym otoczeniu. Same firmy rzadko podają twarde liczby na temat wskaźnika powodzenia zadań poza kontrolowanymi demonstracjami.
Źródła
Linki do materiałów, na których opiera się ten tekst. Zanim oprzesz decyzję na liczbie z artykułu, sprawdź ją w źródle.
O autorach
Z zawodu kierownik techniczny instalacji maszynowej (Chief Engineer, posiada patent). Prowadzi kilka specjalistycznych serwisów branżowych. Ustala zasady redakcyjne serwisu i odpowiada za nie; nie czyta każdej podstrony przed publikacją.
Teksty przygotowuje redakcja z użyciem narzędzi AI. Dane porównujemy z pierwotnymi źródłami próbkowo, a nie każdą stronę z osobna. Zasady opisujemy tutaj: Jak sprawdzamy · O nas